encoder
US
・UK
B1 中級
n.名詞譯碼器
An encoder that changes text into Morse code
影片字幕
AI 再進化!全新AI模型EMO只要影片跟聲音就能生成對嘴動態影片 (EMO: The New AI That Really Shocked The Internet! This is why...)
- The process starts with the audio encoder which extracts acoustic features from the input audio, such as pitch energy and emotion.
這個過程始於音頻編碼器,它從輸入的音頻中提取聲學特徵,如音調、能量和情感。
- Following this, the reference encoder comes into play, encoding the visual identity of the reference image including aspects like face shape, skin tone and hairstyle.
隨後,參考編碼器開始發揮作用,對參考影像的視覺特徵進行編碼,包括臉型、膚色和髮型等方面。
顯示卡怎麼運作?帶你深入探索 GPU 架構! (How do Graphics Cards Work? Exploring GPU Architecture)

- However, engineers in the graphics memory industry agreed to switch to PAM3 for future generations of graphics chips in order to reduce encoder complexity, improve the signal-to-noise ratio, and improve power efficiency.
不過,圖形存儲器行業的工程師們同意在未來幾代圖形芯片中改用 PAM3,以降低編碼器的複雜性,提高信噪比,並提高能效。
- However, engineers in the graphics memory industry agreed to switch to PAM3 for future generations of graphics chips in order to reduce encoder complexity, improve the signal-to-noise ratio,
接下來,我們對桌子和場景中其他數百個物體進行同樣的處理,每次都使用相同的指令,但不同物體的座標在世界空間中,而每個物體的數千個頂點在模型空間中。
AI 如何教會自己看見事物?[DINOv3] (How AI Taught Itself to See [DINOv3])
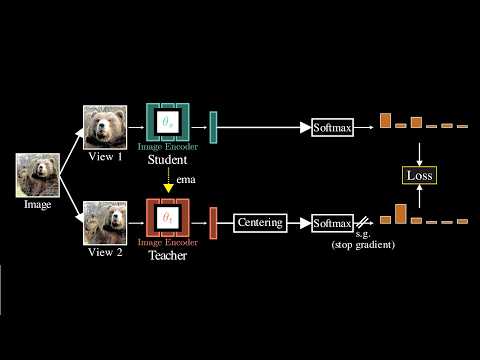
- To use this extra information, we add a text encoder.
為了使用這些額外資訊,我們添加了一個文本編碼器。
- The text encoder turns the caption or description into a feature vector, just like the image encoder does for the image.
文本編碼器會將標題或說明轉化為特徵向量,就像影像編碼器處理影像一樣。
AI 圖像和影片是怎麼運作的?|Welch Labs 獨家影片! (But how do AI images and videos actually work? | Guest video by Welch Labs)
- We can search for corresponding text by passing a bunch of different words into our text encoder, and for each computing the cosine similarity between our newly computed difference vector and the text vector.
我們可以將一系列不同的單詞輸入文本編碼器,然後計算新計算出的差異向量與文本向量之間的餘弦相似度,從而搜索相應的文本。
- The OpenAI team showed that CLIP could produce very impressive image classification results by simply passing an image into our image encoder and then comparing the resulting vector to a set of possible captions, one for each label that could be assigned to the image, and classifying the image with whatever label resulted in the highest cosine similarity.
OpenAI 團隊證明,CLIP 可以生成非常令人印象深刻的影像分類結果,只需將影像傳入我們的影像編碼器,然後將生成的向量與一組可能的標題進行比較,每一個標籤都可以分配給影像,並將影像分類為餘弦相似度最高的標籤。
Google 翻譯如何運用數學理解 134 種語言 | WSJ 科技背後 (How Google Translate Uses Math to Understand 134 Languages | WSJ Tech Behind)
- So that's called the encoder stage.
這就是所謂的編碼器階段。
- So that's called the encoder stage.
這就是所謂的編碼器階段。
大型語言模型入門教學! (Introduction to large language models)
- A transformer model consists of encoder and decoder.
變壓器模型由編碼器和解碼器組成。
- The encoder encodes the input sequence and passes it to the decoder, which learns how to decode the representations for a relevant task.
編碼器對輸入序列進行編碼,然後將其傳遞給解碼器,解碼器學習如何對相關任務的表徵進行解碼。
使用 Python 從零開始建構並訓練 GLM-5.3-Flash 模型! (Build & Train a GLM-5.3-Flash Model From Scratch with Python)
- So this is just for our encoder.
所以這只是為了我們的編碼器。
- GPT has any image encoder, you know, these other models.
GPT 有任何影像編碼器,或是你們知道的那些其他模型。
Transformer 架構大解密! (Transformer Architecture Explained)
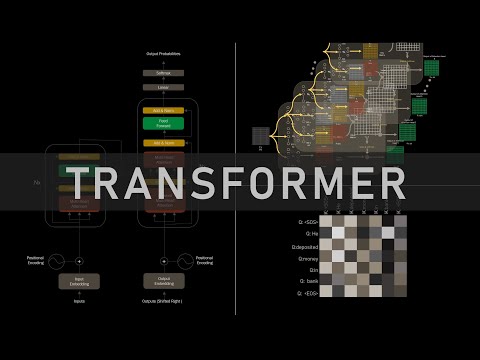
- The Transformer architecture has two main parts, the encoder and the decoder,
Transformer 架構主要由兩個部分組成,分別是編碼器與解碼器。
- The source language becomes input to the encoder, and the target language becomes input to the decoder.
來源語言會成為編碼器的輸入,而目標語言則會成為解碼器的輸入。